

Kueue Monitoring
Kueue가 관리하는 클러스터의 규모, 워크로드 상태, 스케줄링 성능, 자원 용량을 한 화면에서 봅니다.
사전 조건
- AI Inference Admin에 접근할 수 있는 관리자 계정
사이드바에서 Kueue → Kueue Monitoring을 클릭합니다.
화면 제목
현재 demo에서는 화면 제목이 pageTitles.monitoring으로 표시됩니다. 번역 문구가 빠진 것으로, 기능에는 영향이 없습니다.
Cluster summary · Workload metrics
클러스터 규모와 Kueue 워크로드 상태를 요약합니다.
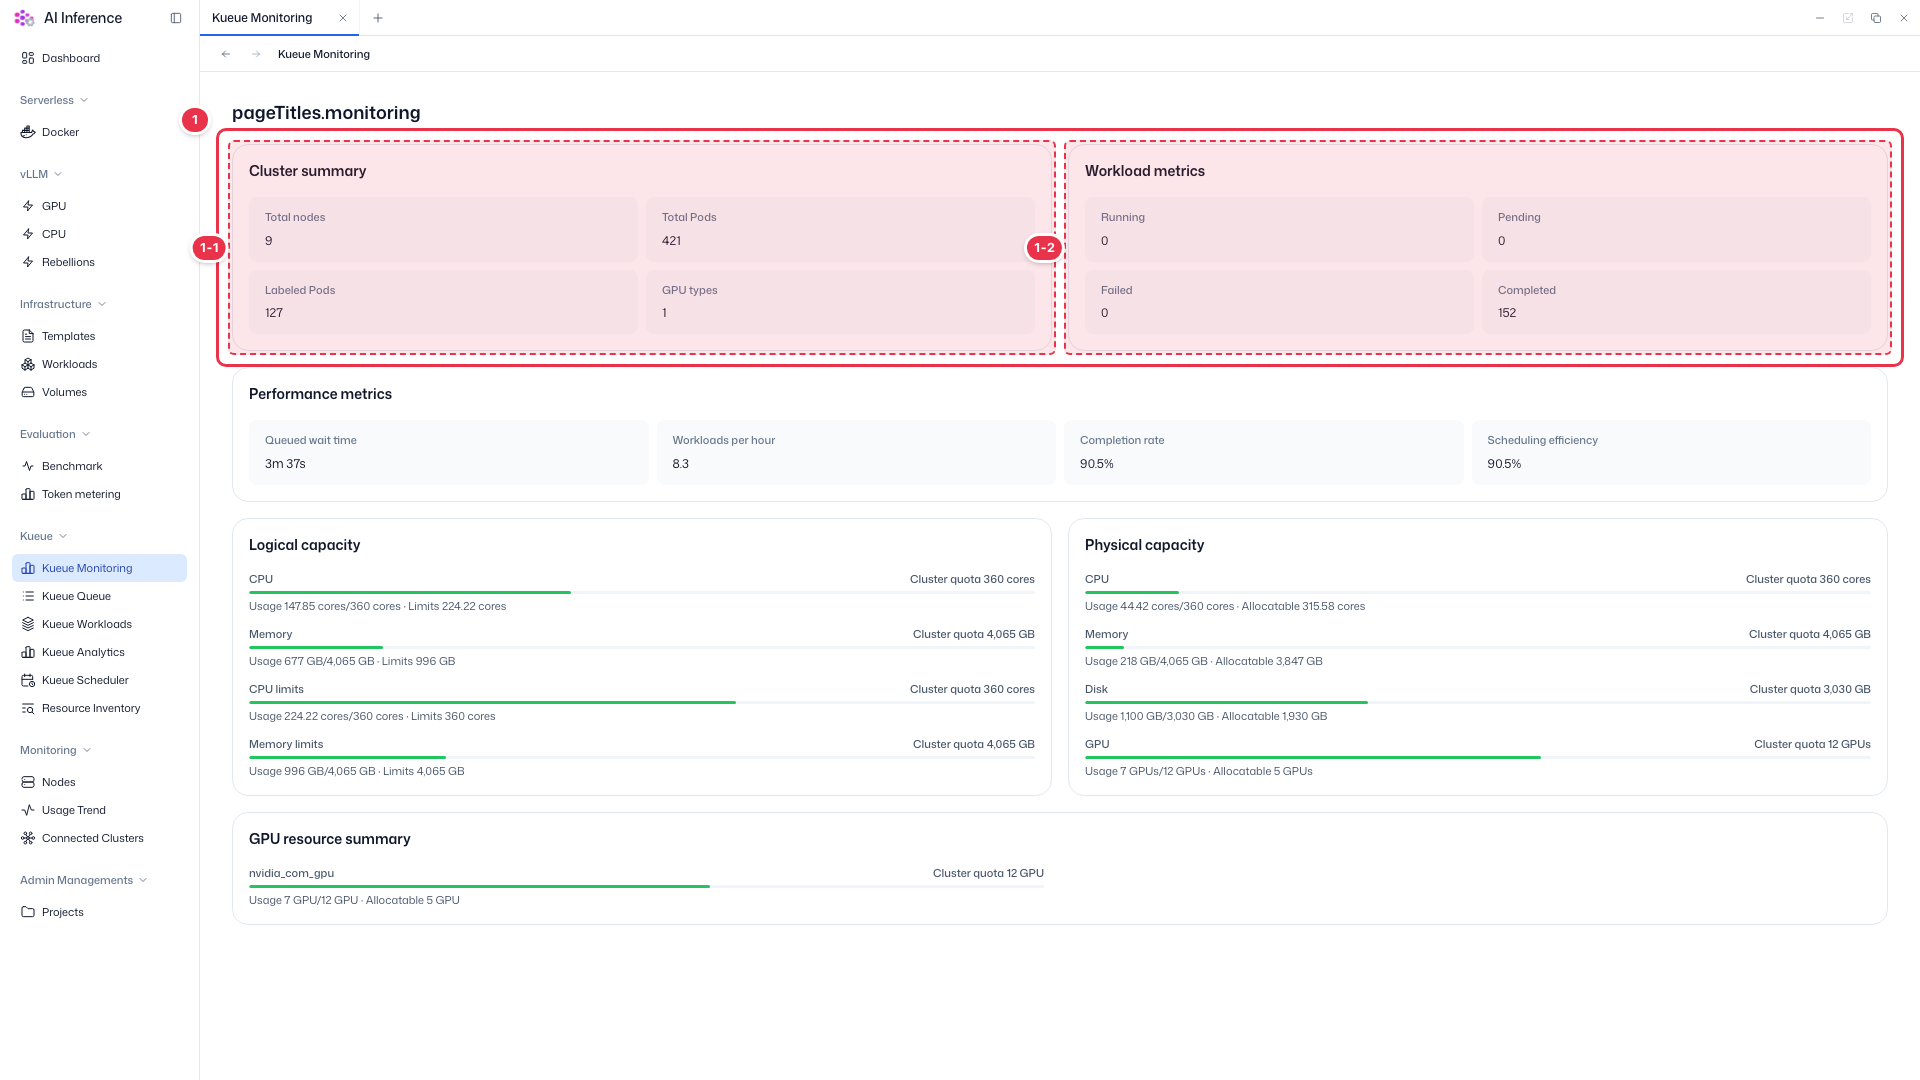
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 1-1 | Cluster summary | Total nodes · Total Pods · Labeled Pods · GPU types | · 전체 노드와 파드 수, Kueue 라벨이 붙은 파드 수, GPU 종류 수입니다. |
| 1-2 | Workload metrics | Running · Pending · Failed · Completed | · Kueue가 관리하는 워크로드의 상태별 개수입니다. |
Performance metrics
대기열 스케줄링이 얼마나 원활한지 보여줍니다.
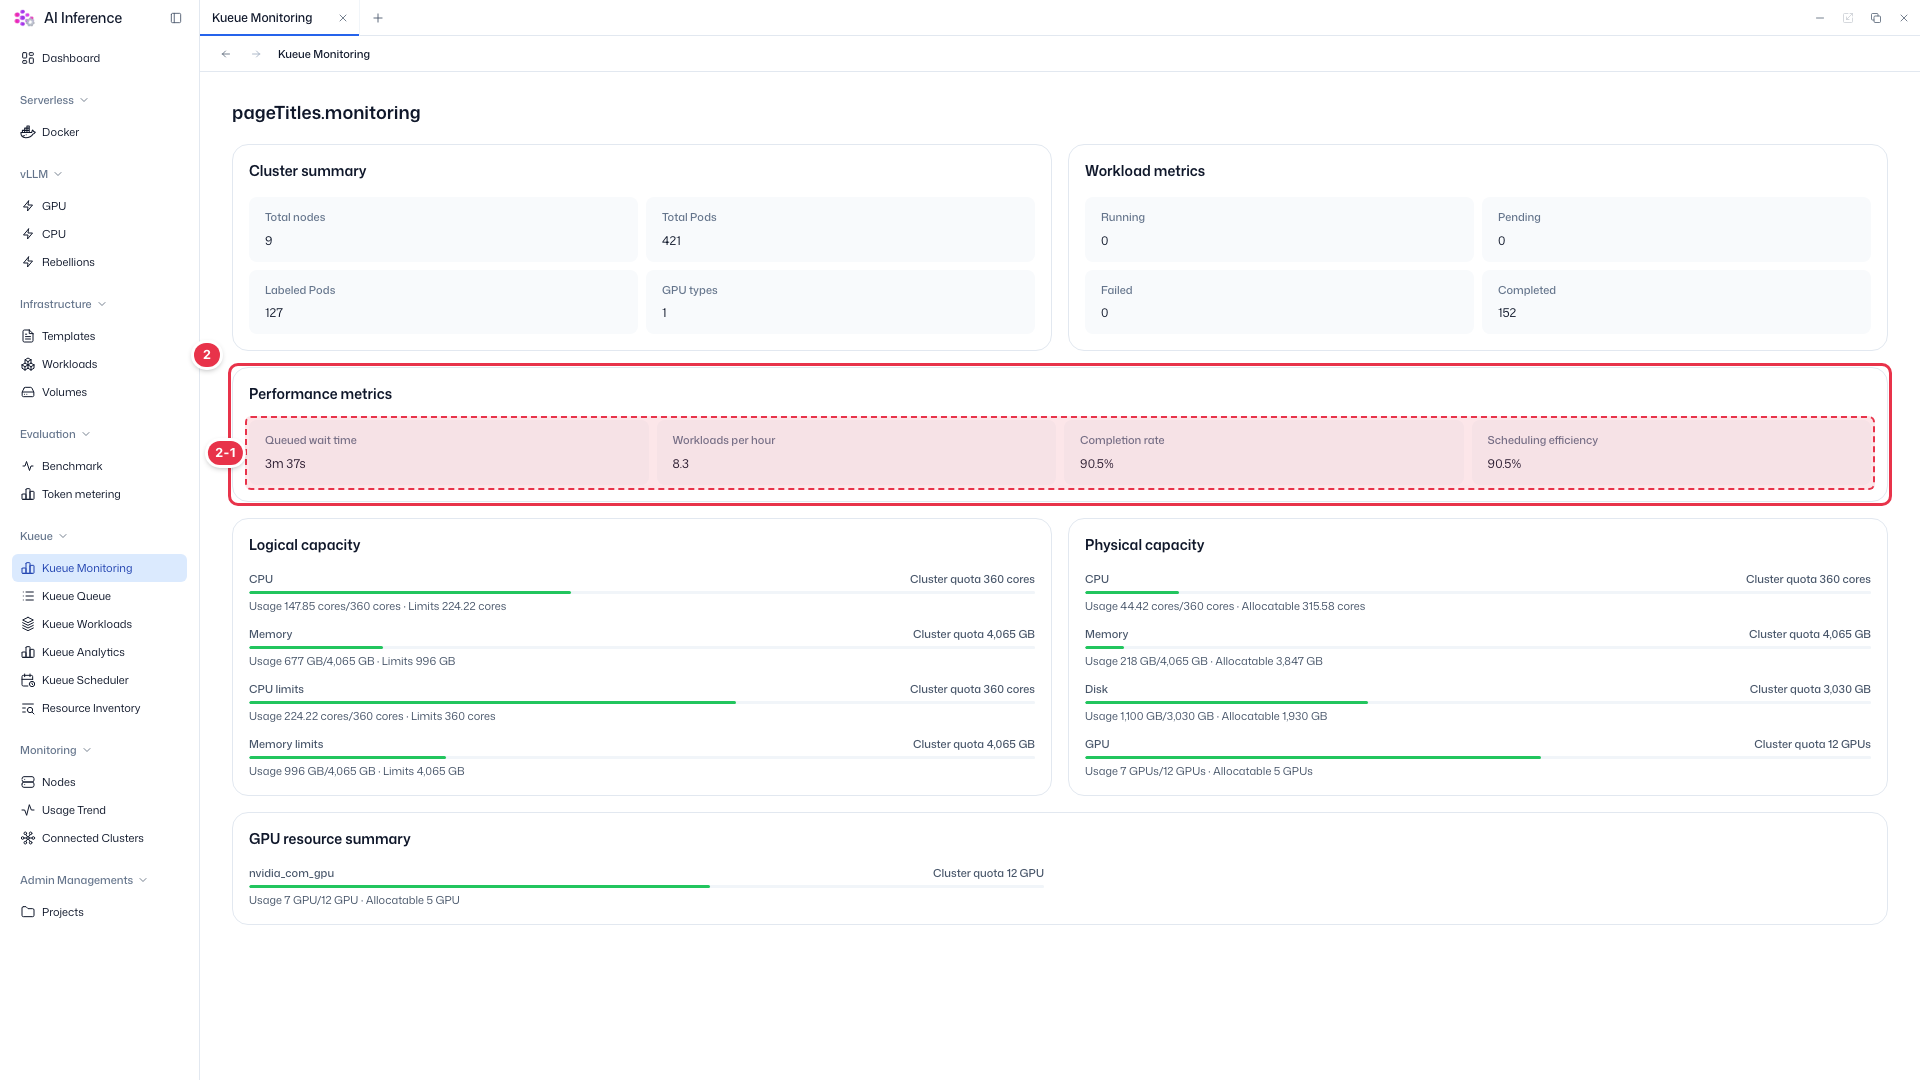
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 2-1 | 지표 | Queued wait time | 워크로드가 대기열에서 기다린 평균 시간입니다. |
| Workloads per hour | 시간당 처리한 워크로드 수입니다. | ||
| Completion rate | 끝까지 완료된 워크로드 비율입니다. | ||
| Scheduling efficiency | 요청한 자원이 제때 배정된 비율입니다. |
Logical · Physical capacity
할당량 기준(논리)과 실제 노드 기준(물리)의 자원 사용량을 나란히 봅니다.
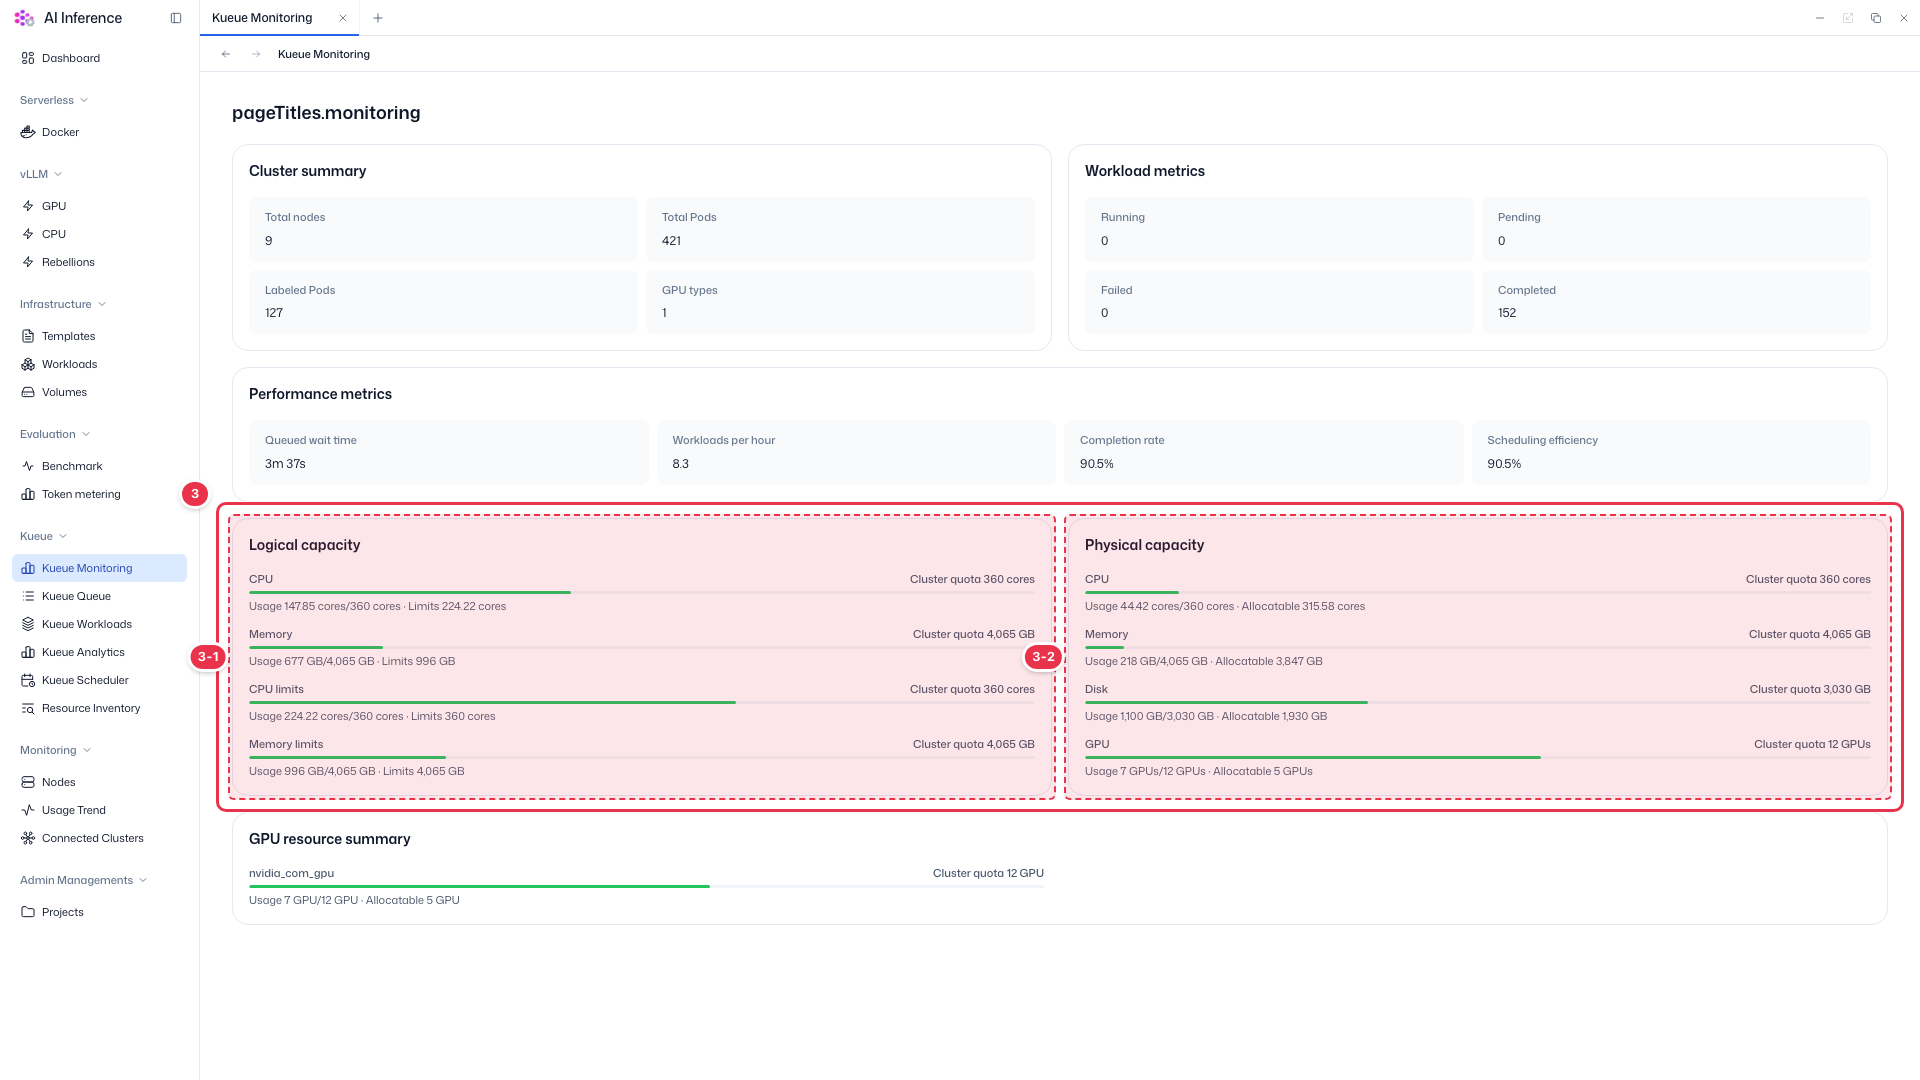
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 3-1 | Logical capacity | CPU · Memory · 한도 | · 클러스터 할당량 대비 요청량(Usage)과 한도(Limits)입니다. 실제 사용이 아니라 예약한 양입니다. |
| 3-2 | Physical capacity | CPU · Memory · Disk · GPU | · 노드에서 실제로 쓰고 있는 양과 추가로 쓸 수 있는 양(Allocatable)입니다. 막대가 빨간색이면 거의 다 찬 상태입니다. |
GPU resource summary
GPU 종류별 할당량과 사용량, 남은 양입니다.
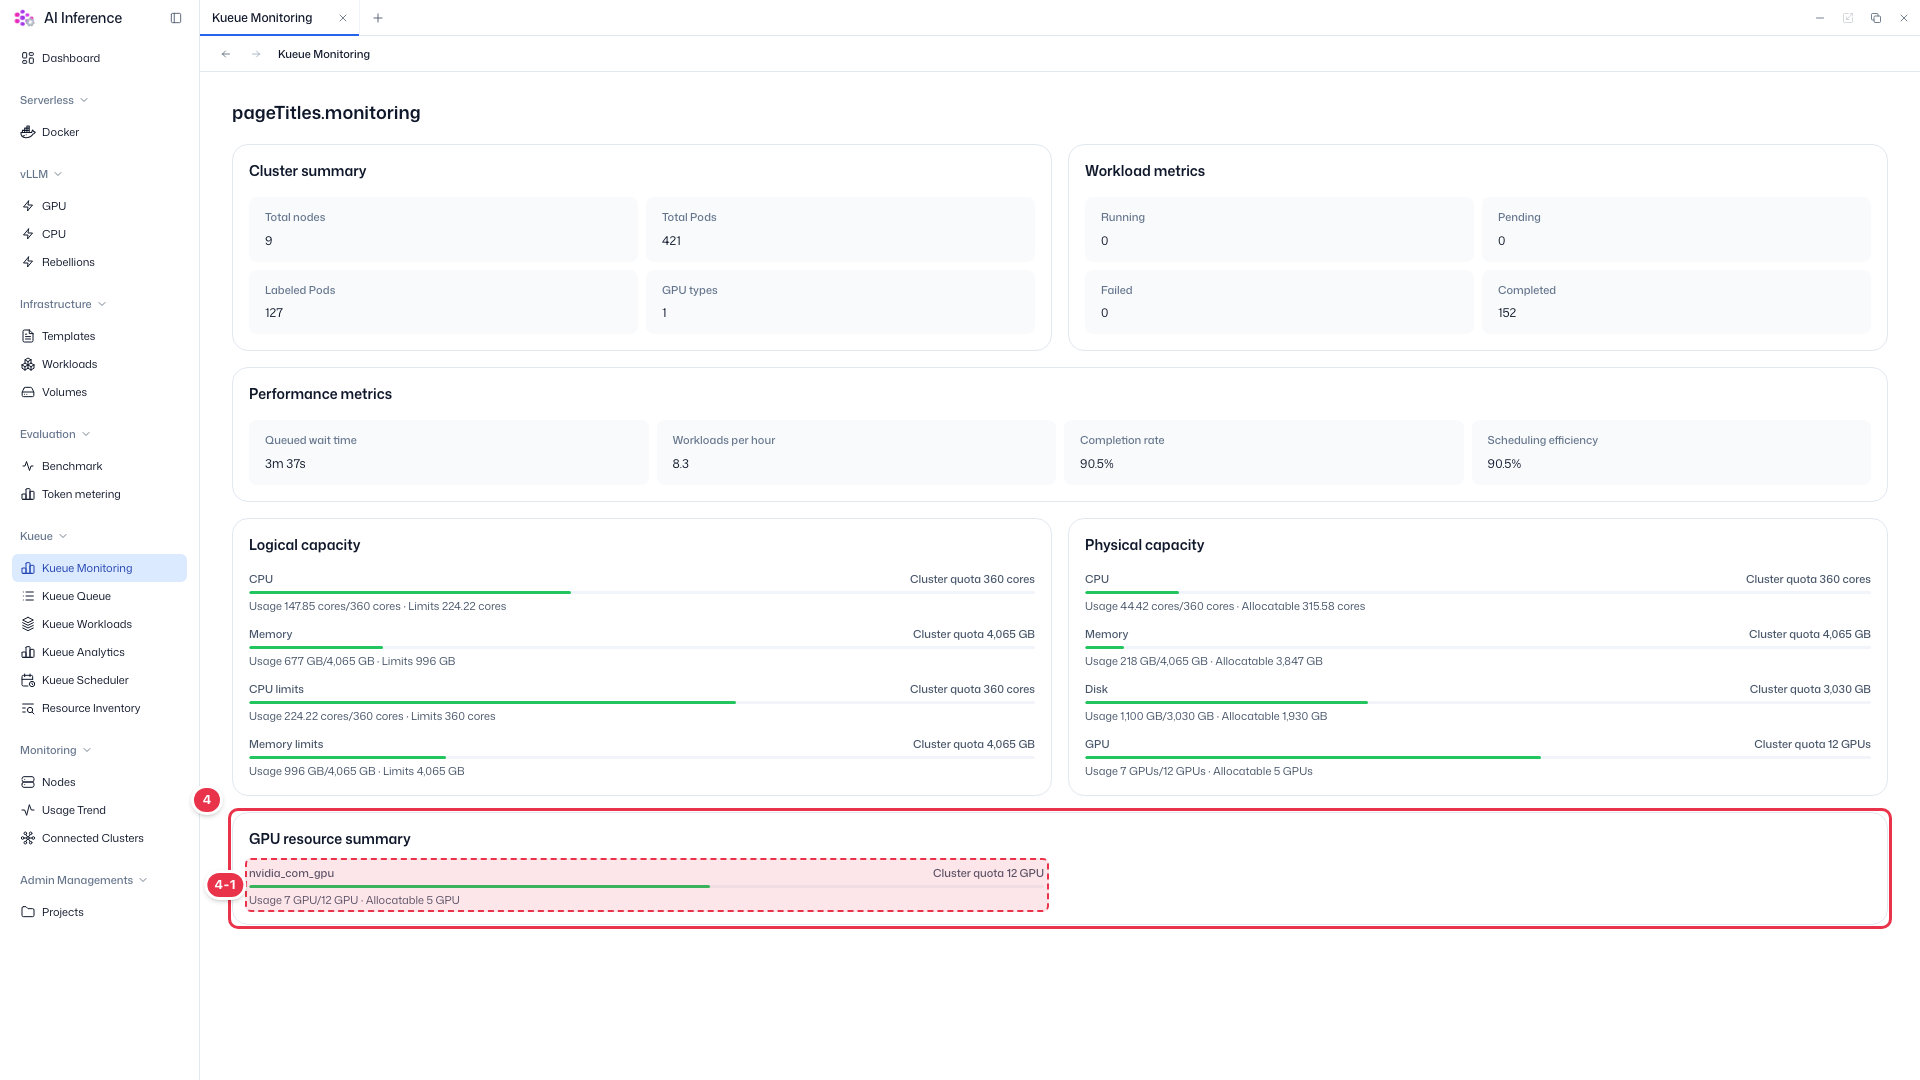
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 4-1 | GPU 종류 | 예: nvidia_com_gpu | · GPU 리소스 이름별로 Usage와 Allocatable을 보여줍니다. |