

Tabular 실험 생성
테이블 데이터 기반 학습 실험을 생성합니다. 생성은 Select domain → Upload data → Column setup → Model Setup 4단계 마법사로 진행하며, 각 단계 하단의 Next 버튼으로 이동합니다(단계 완료 조건을 충족해야 활성화).
아래 화면의 번호를 따라 각 단계의 항목 위치와 역할을 확인하세요.
생성 진입 버튼
실험 목록 우측 상단의 Create experiment 버튼. 클릭하면 실험 생성 마법사로 이동한다.
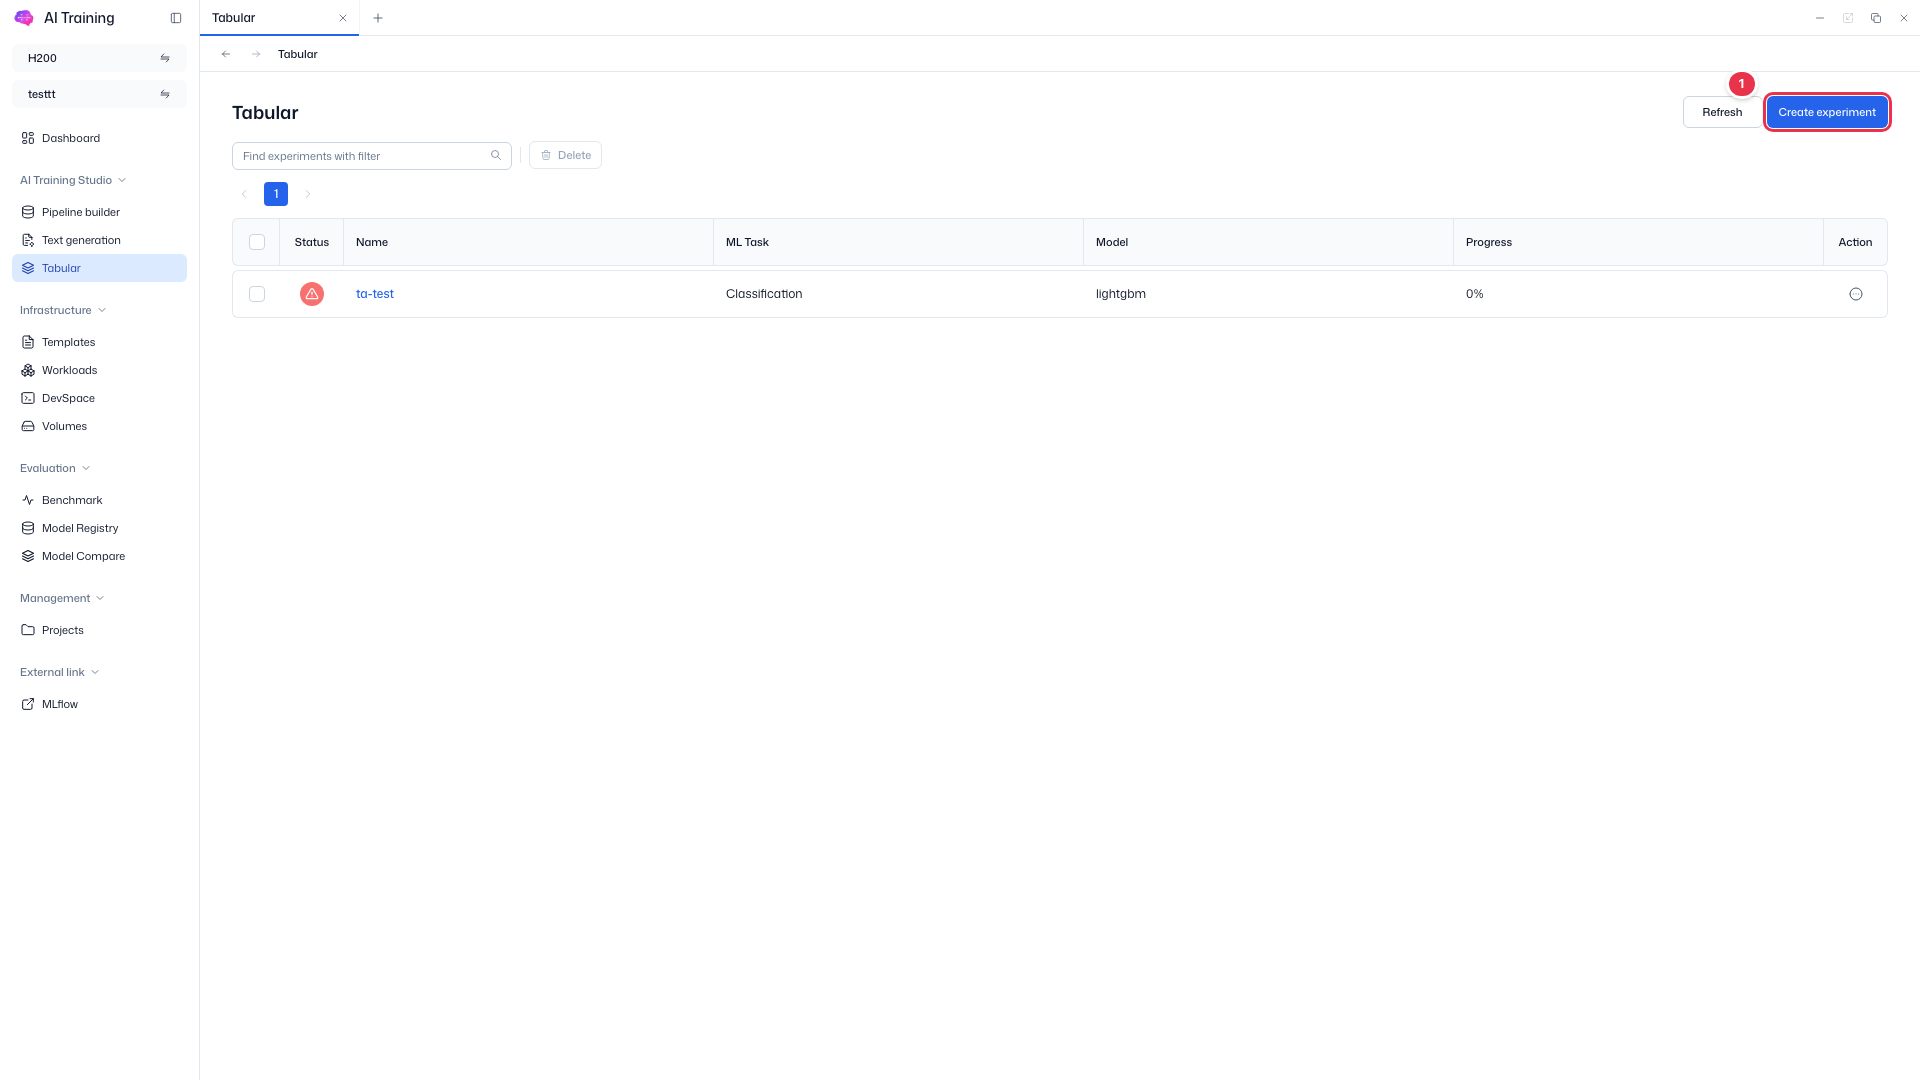
1단계 — Select domain (도메인 선택)
Tabular 학습 실험을 단계별로 정의하는 마법사. 상단 4개 단계 탭을 Next 로 순서대로 진행하며, 우측 Summary에서 완료 상태를 확인한다. 1단계에서 업종 도메인을 고른다.
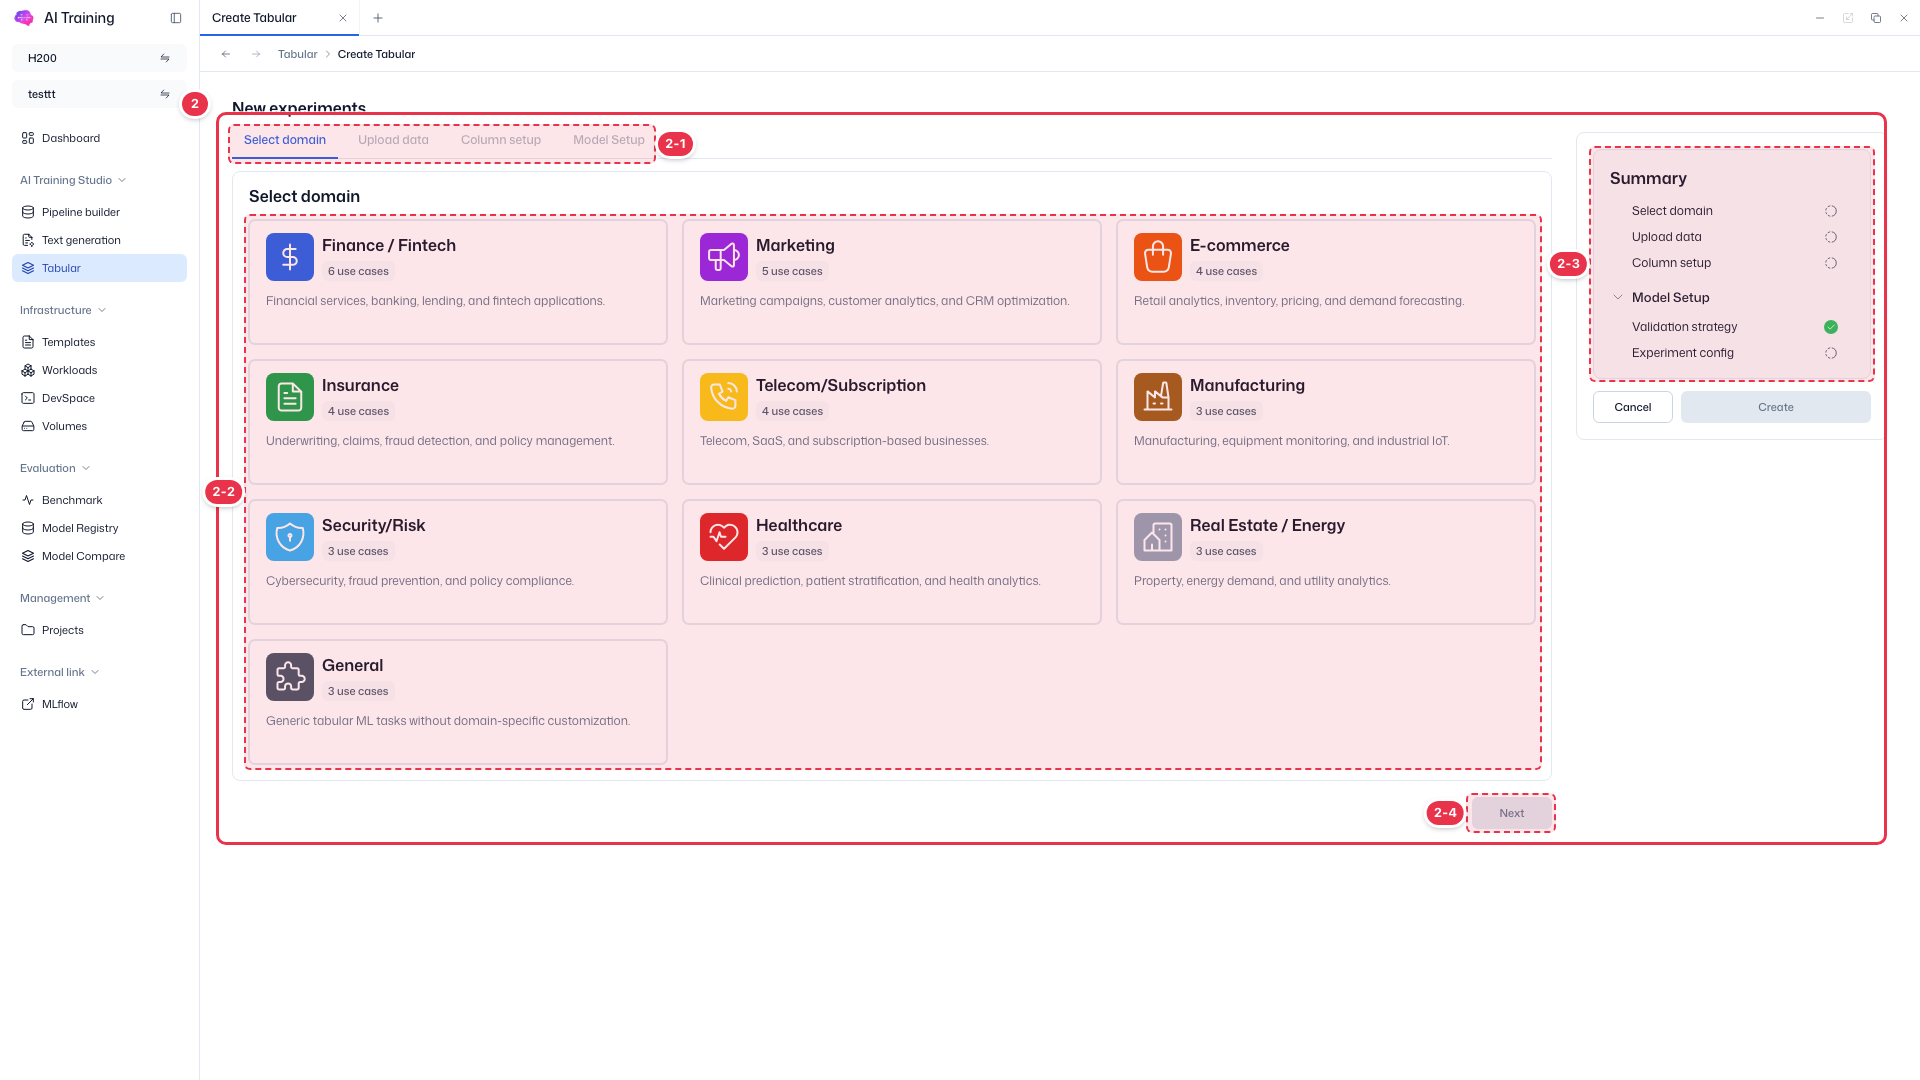
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 2-1 | 단계 탭 | Select domain | 도메인(업종)·use case 선택(1단계, 현재). |
| Upload data | 학습 데이터셋 선택/업로드(2단계). | ||
| Column setup | Target variable·Exclude Columns 설정(3단계). | ||
| Model Setup | Validation strategy·Experiment config 설정(4단계). | ||
| 2-2 | 도메인 선택 | Finance / Marketing / E-commerce / Insurance / Telecom / Manufacturing / Security / Healthcare / Real Estate / General | · 업종 도메인 카드를 선택하면 아래에 use case 목록이 나타난다. |
| 2-3 | 요약 패널 | Summary (단계별 완료 상태) | · 각 단계 입력 완료 상태를 표시한다. |
| 2-4 | 다음 단계 | Next | · Next: 다음 단계로 이동(완료 조건 충족 시 활성). · Create: 마지막 단계에서 실험을 생성. · Cancel: 생성을 취소. |
1단계 — Select a use case (유즈케이스)
선택한 도메인에 해당하는 use case를 고른다. use case를 선택하면 Next 가 활성화된다.
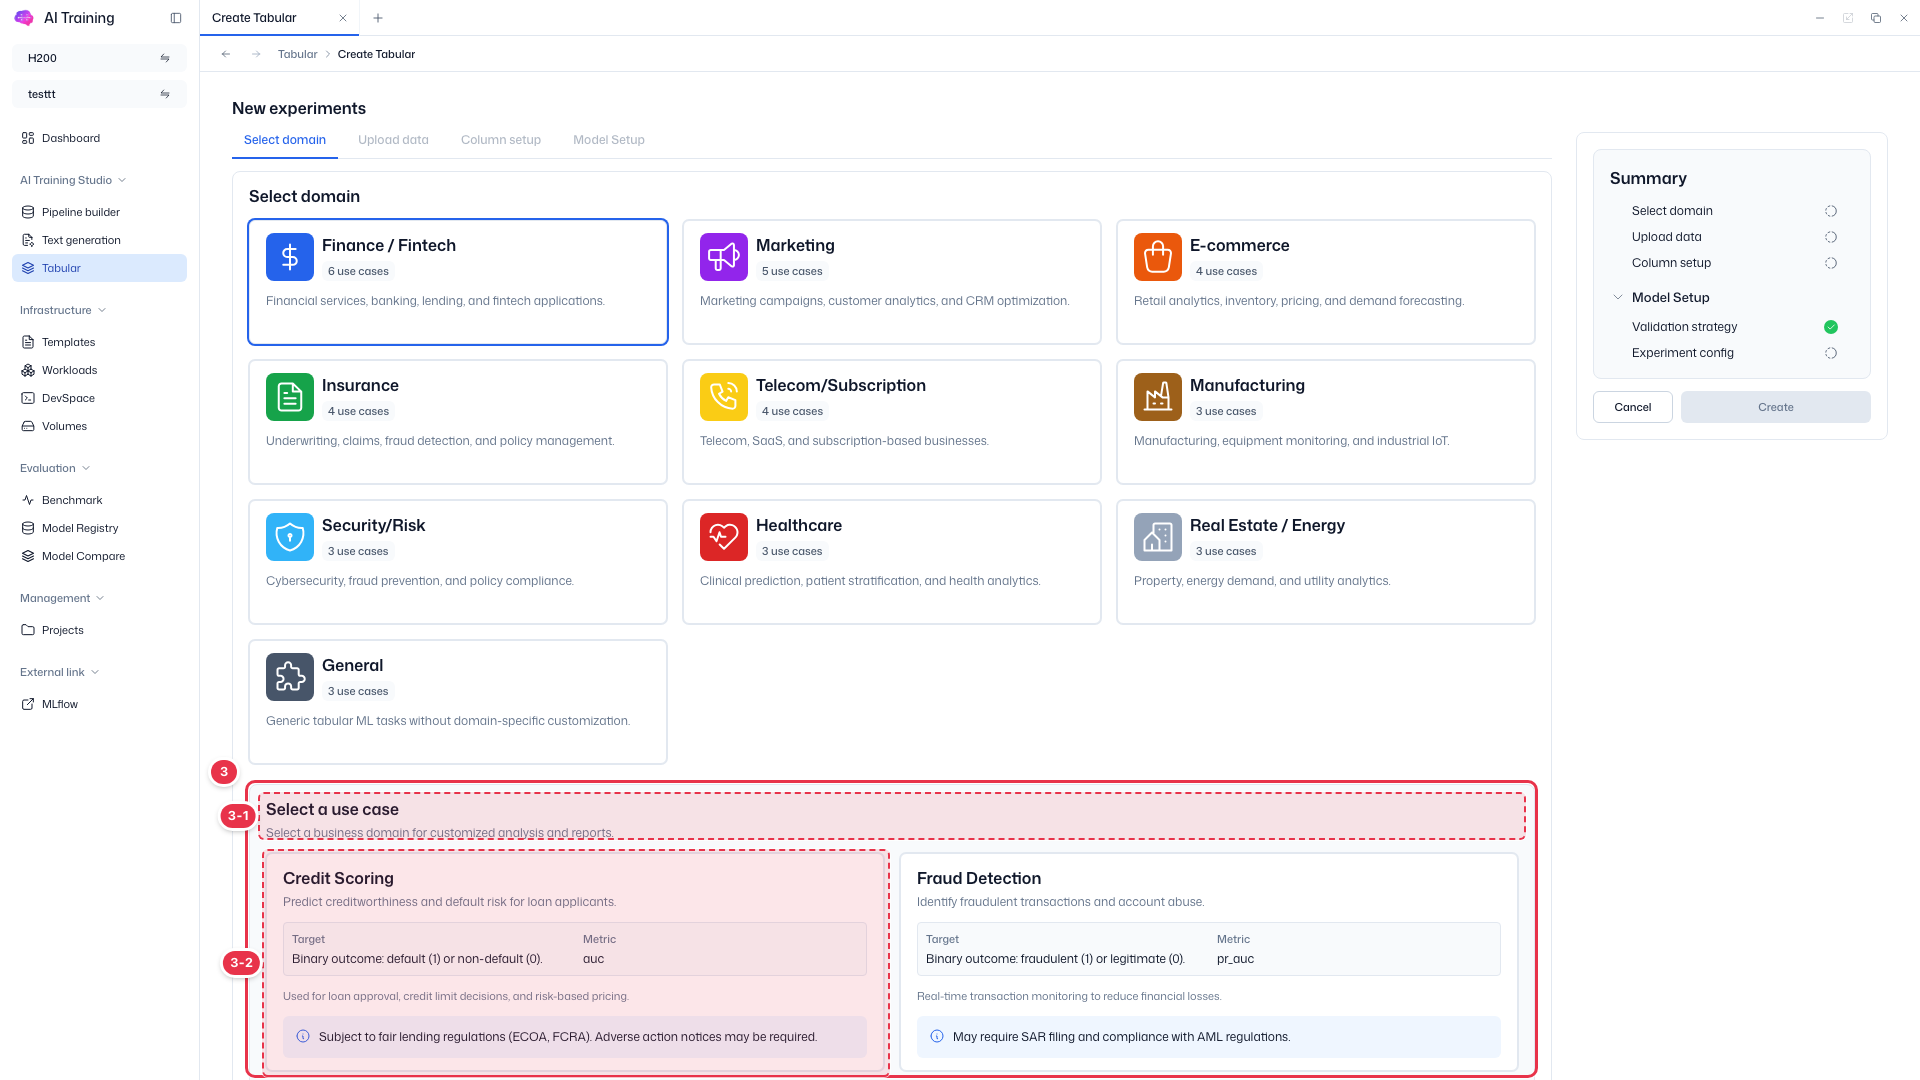
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 3-1 | 유즈케이스 영역 | Select a use case | · 예: Finance → Credit Scoring / Fraud Detection / Campaign Targeting / Limit Optimization / Collection Priority / Churn Prediction. |
| 3-2 | use case 카드 | use case 카드 (metric·target 요약 포함) | · 각 카드에 목적·metric·target이 요약되어 있다. 선택 후 Next 로 2단계 진행. |
2단계 — Upload data (데이터셋 선택)
학습에 사용할 데이터셋을 선택하거나 업로드한다. 선택 후 Next 로 3단계 진행.
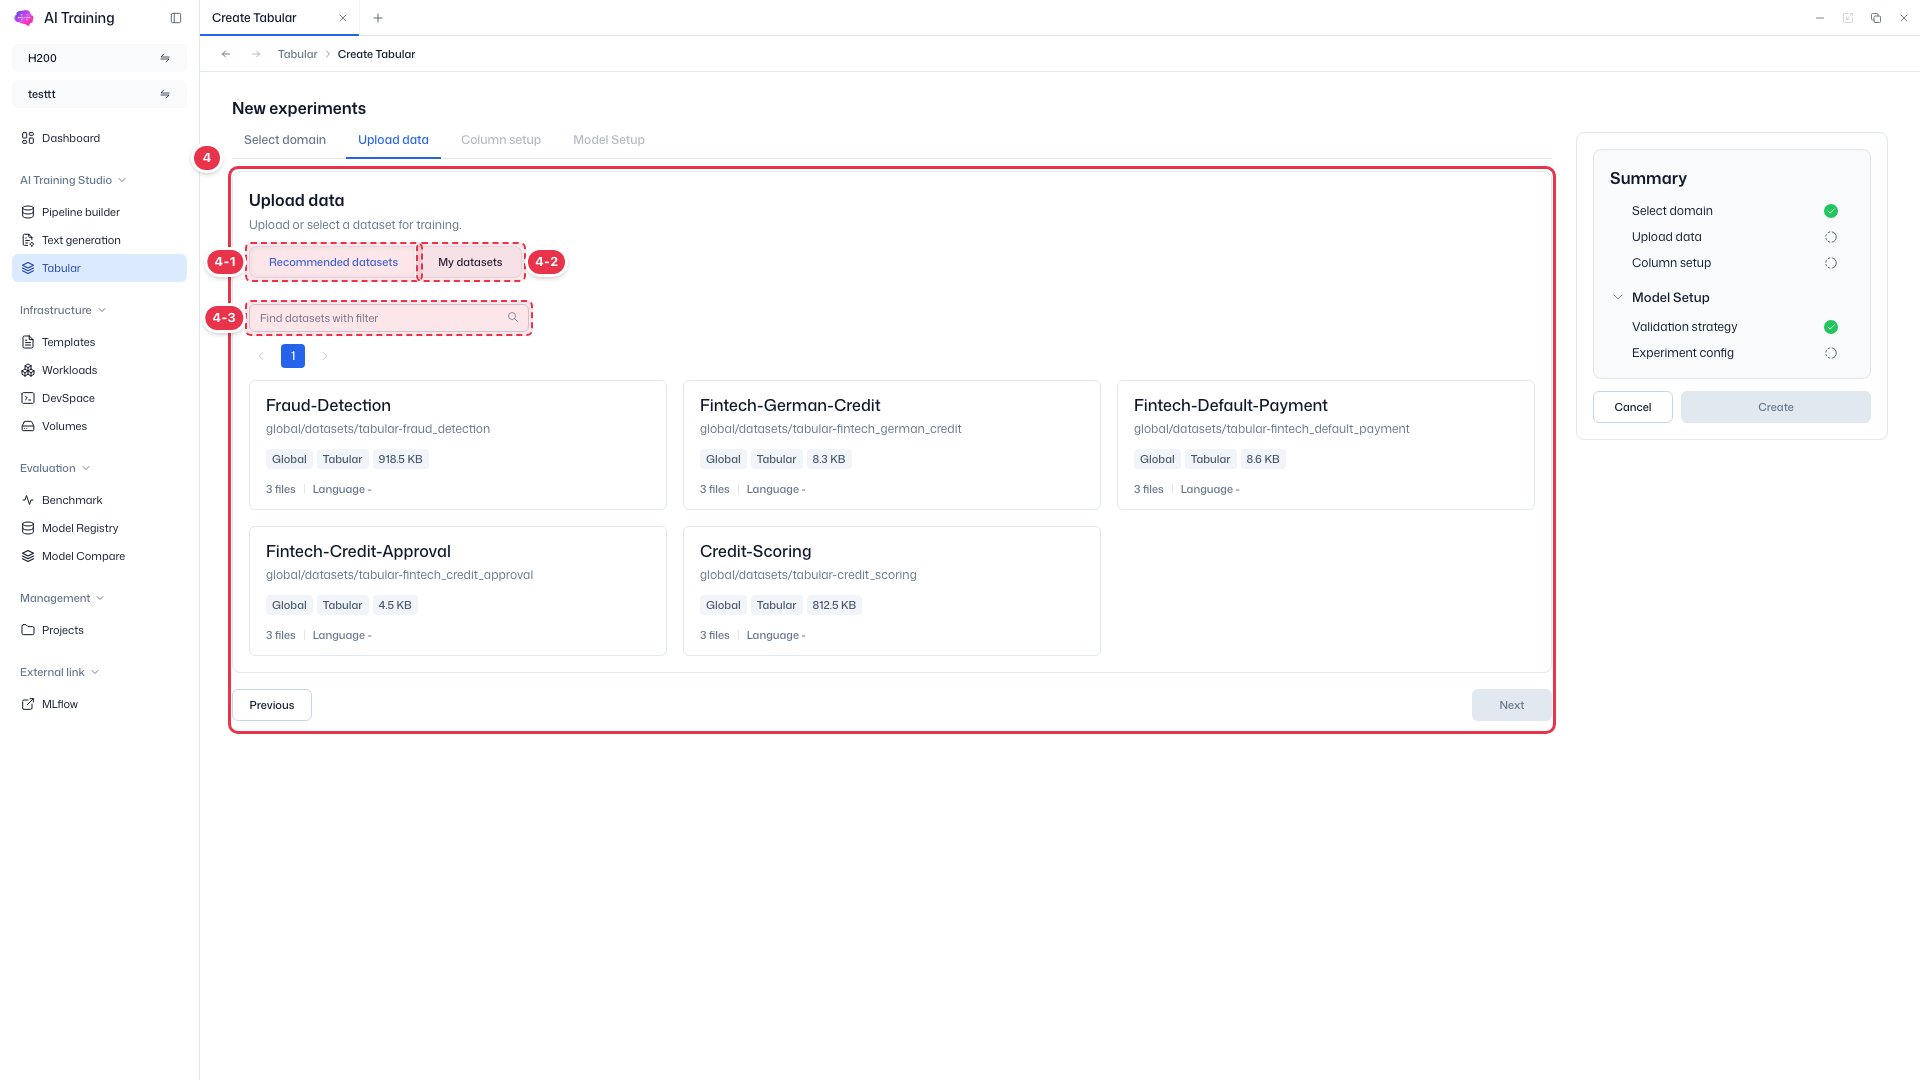
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 4-1 | 추천 데이터셋 | Recommended datasets 탭 | · 도메인/use case에 맞는 추천 데이터셋 목록. |
| 4-2 | 내 데이터셋 | My datasets 탭 | · 프로젝트에 업로드된 사용자 데이터셋 목록. |
| 4-3 | 데이터셋 검색 | Find datasets with filter | · 이름 등으로 데이터셋을 검색한다. |
3단계 — Column setup (컬럼 설정)
예측 대상(Target variable)과 학습에서 제외할 컬럼(Exclude Columns)을 지정한다. Target 선택 후 Next 로 4단계 진행.
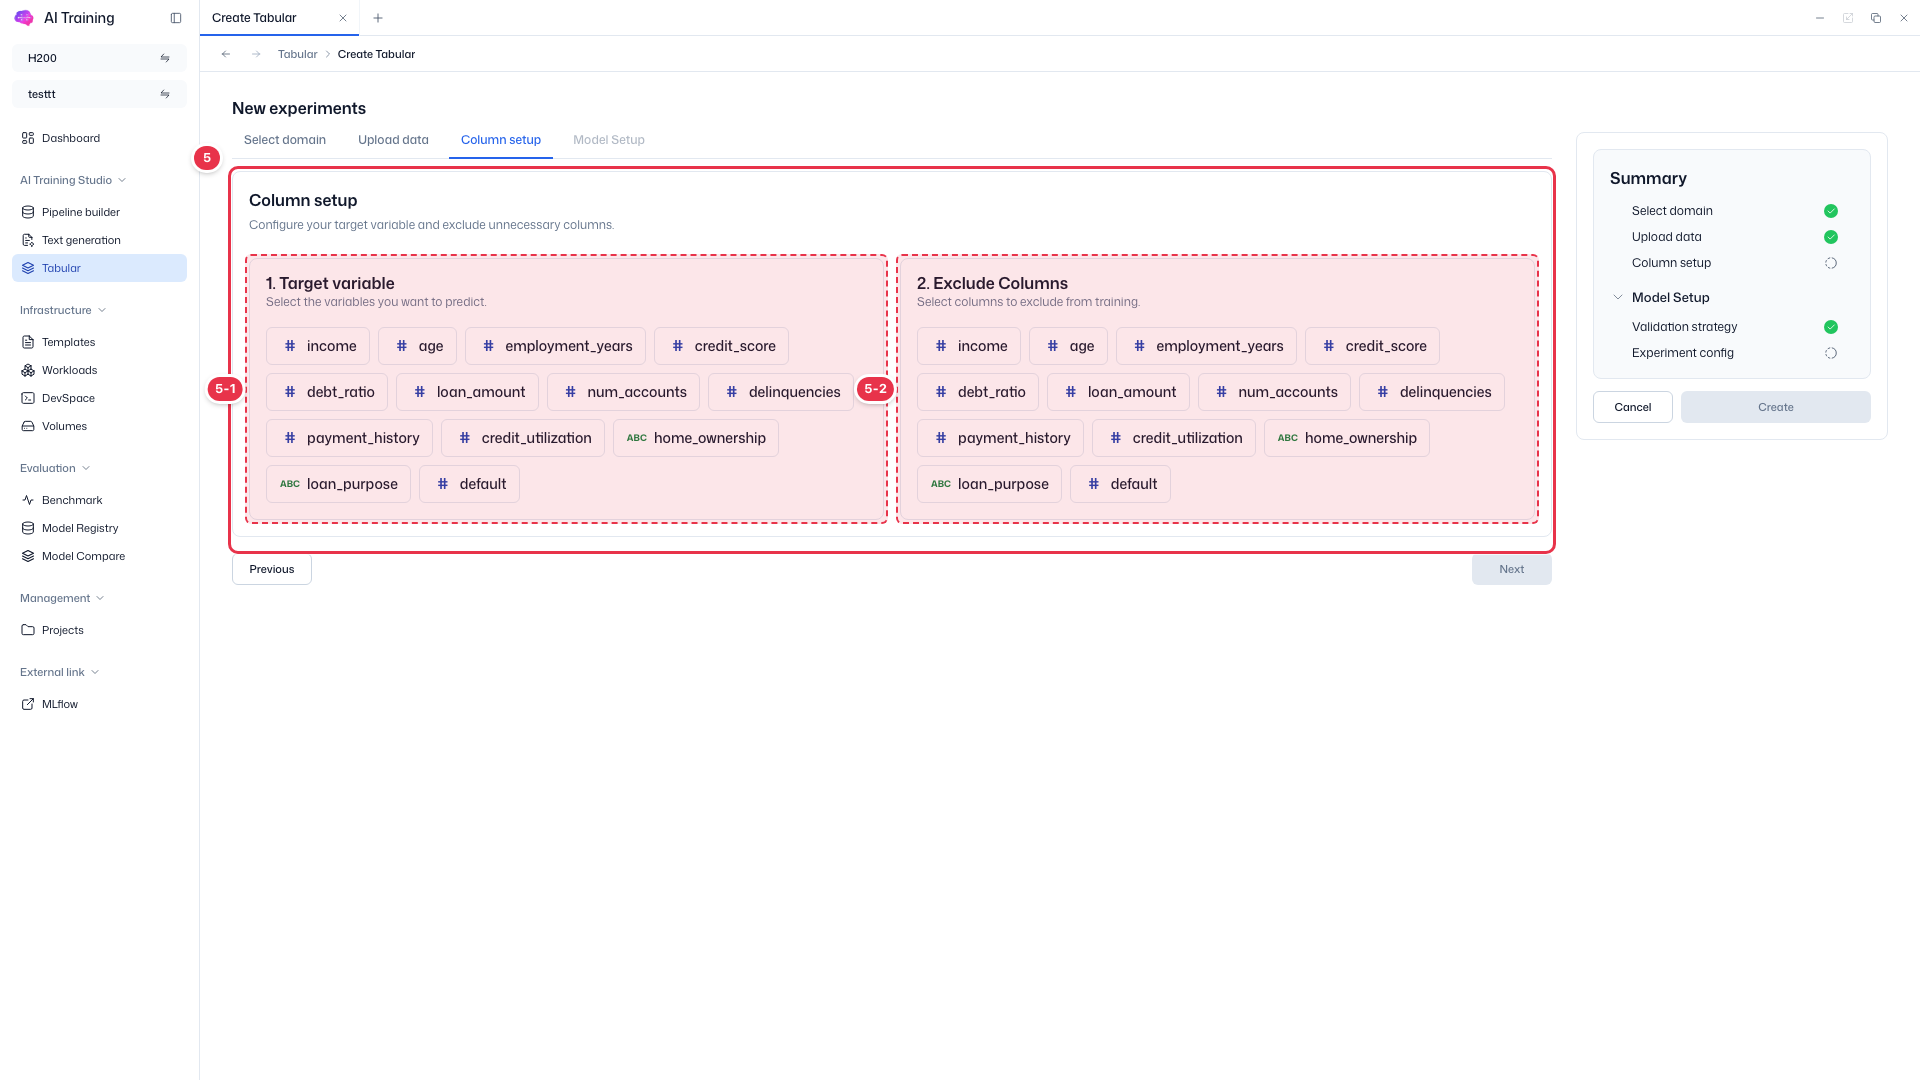
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 5-1 | 타깃 변수 | 1. Target variable (예측 대상 컬럼) | · 모델이 예측할 대상 컬럼을 선택한다(필수). |
| 5-2 | 제외 컬럼 | 2. Exclude Columns (학습 제외 컬럼) | · 학습에 사용하지 않을 컬럼을 선택한다(선택). |
4단계 — Model Setup · Validation strategy
학습/검증/테스트 분할 방식과 평가 지표를 설정한다.
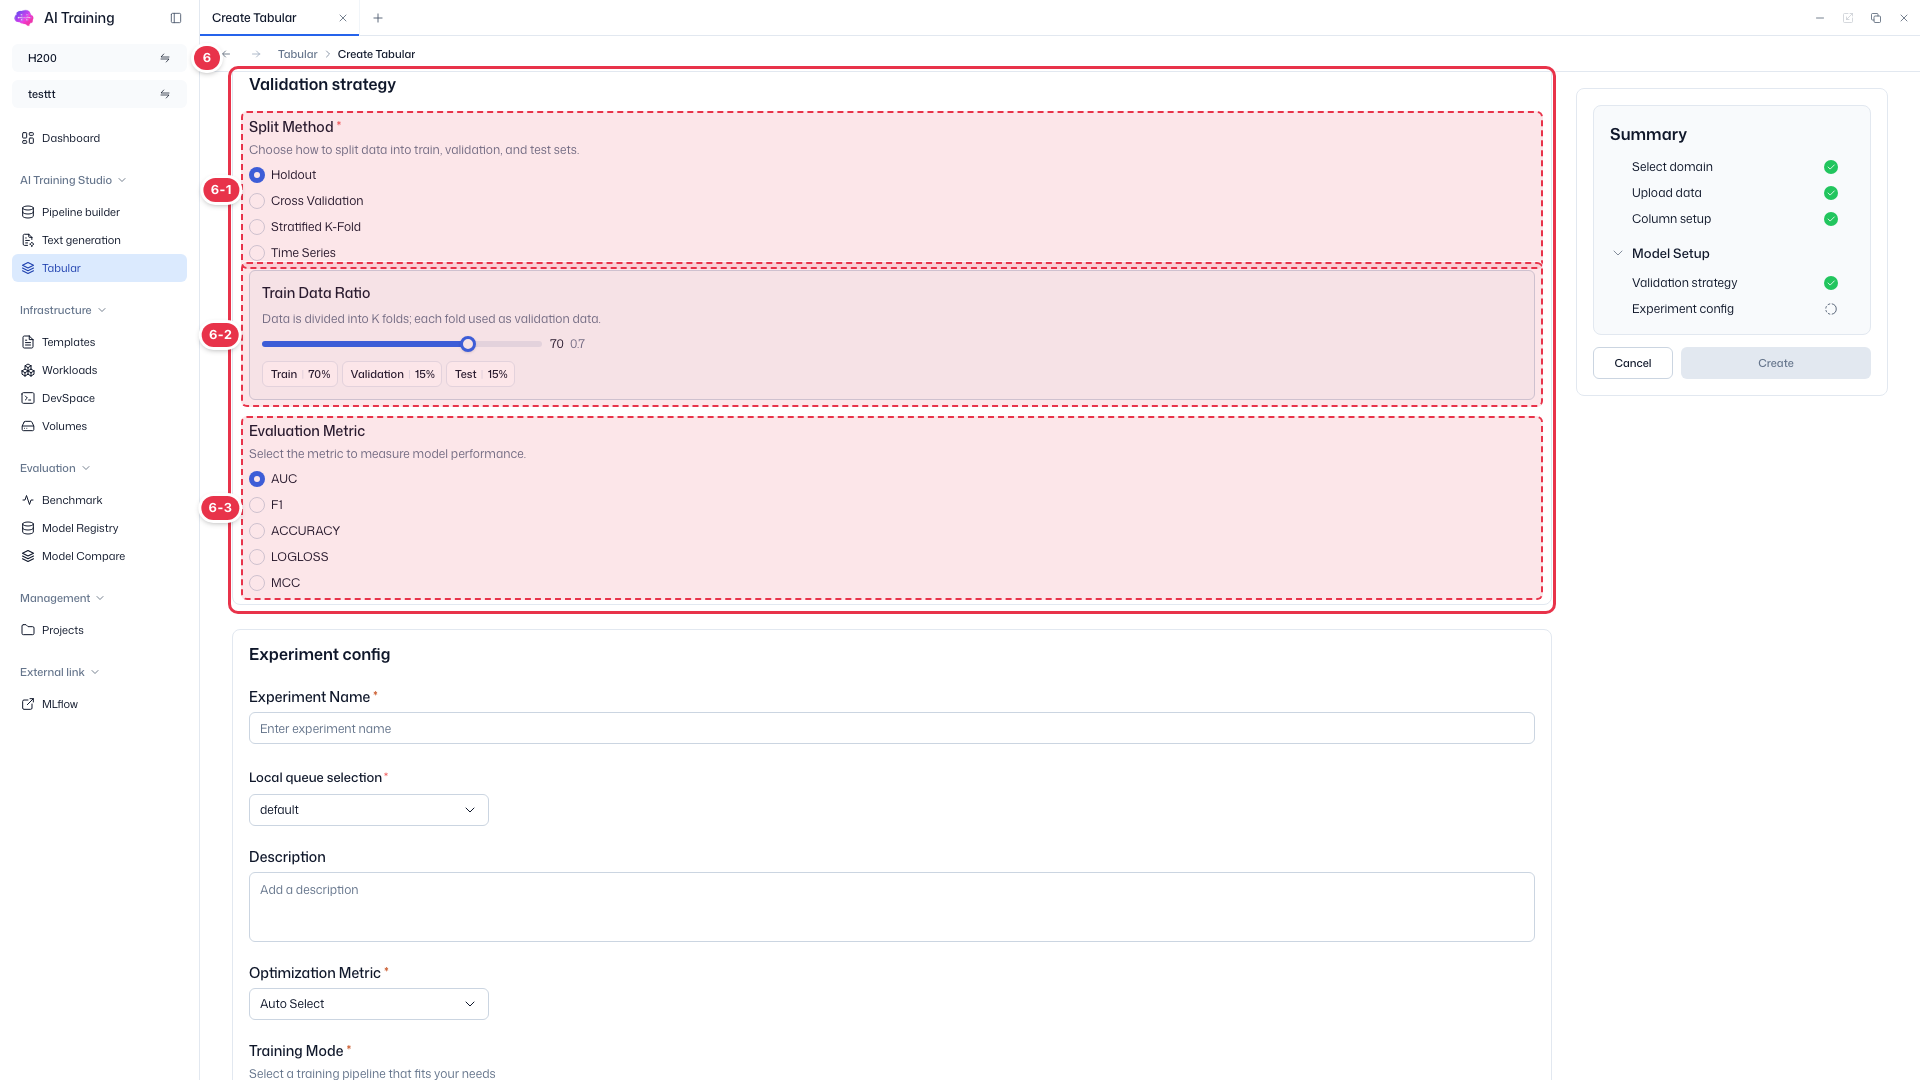
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 6-1 | 분할 방식 | Split Method (Holdout · Cross Validation · Stratified K-Fold · Time Series) | · 데이터를 train/validation/test 로 나누는 방식을 선택한다. |
| 6-2 | 분할 비율 | Train Data Ratio (Train · Validation · Test %) | · 학습/검증/테스트 데이터 비율을 슬라이더로 조정한다. |
| 6-3 | 평가 지표 | Evaluation Metric (AUC · F1 · ACCURACY · LOGLOSS · MCC) | · 모델 성능을 측정할 지표를 선택한다. |
4단계 — Model Setup · Experiment config + 생성
실험 이름·큐·최적화 지표와 학습 모델(LightGBM·XGBoost·CatBoost·Logistic Regression·Random Forest)을 설정하고 Create 로 생성한다.
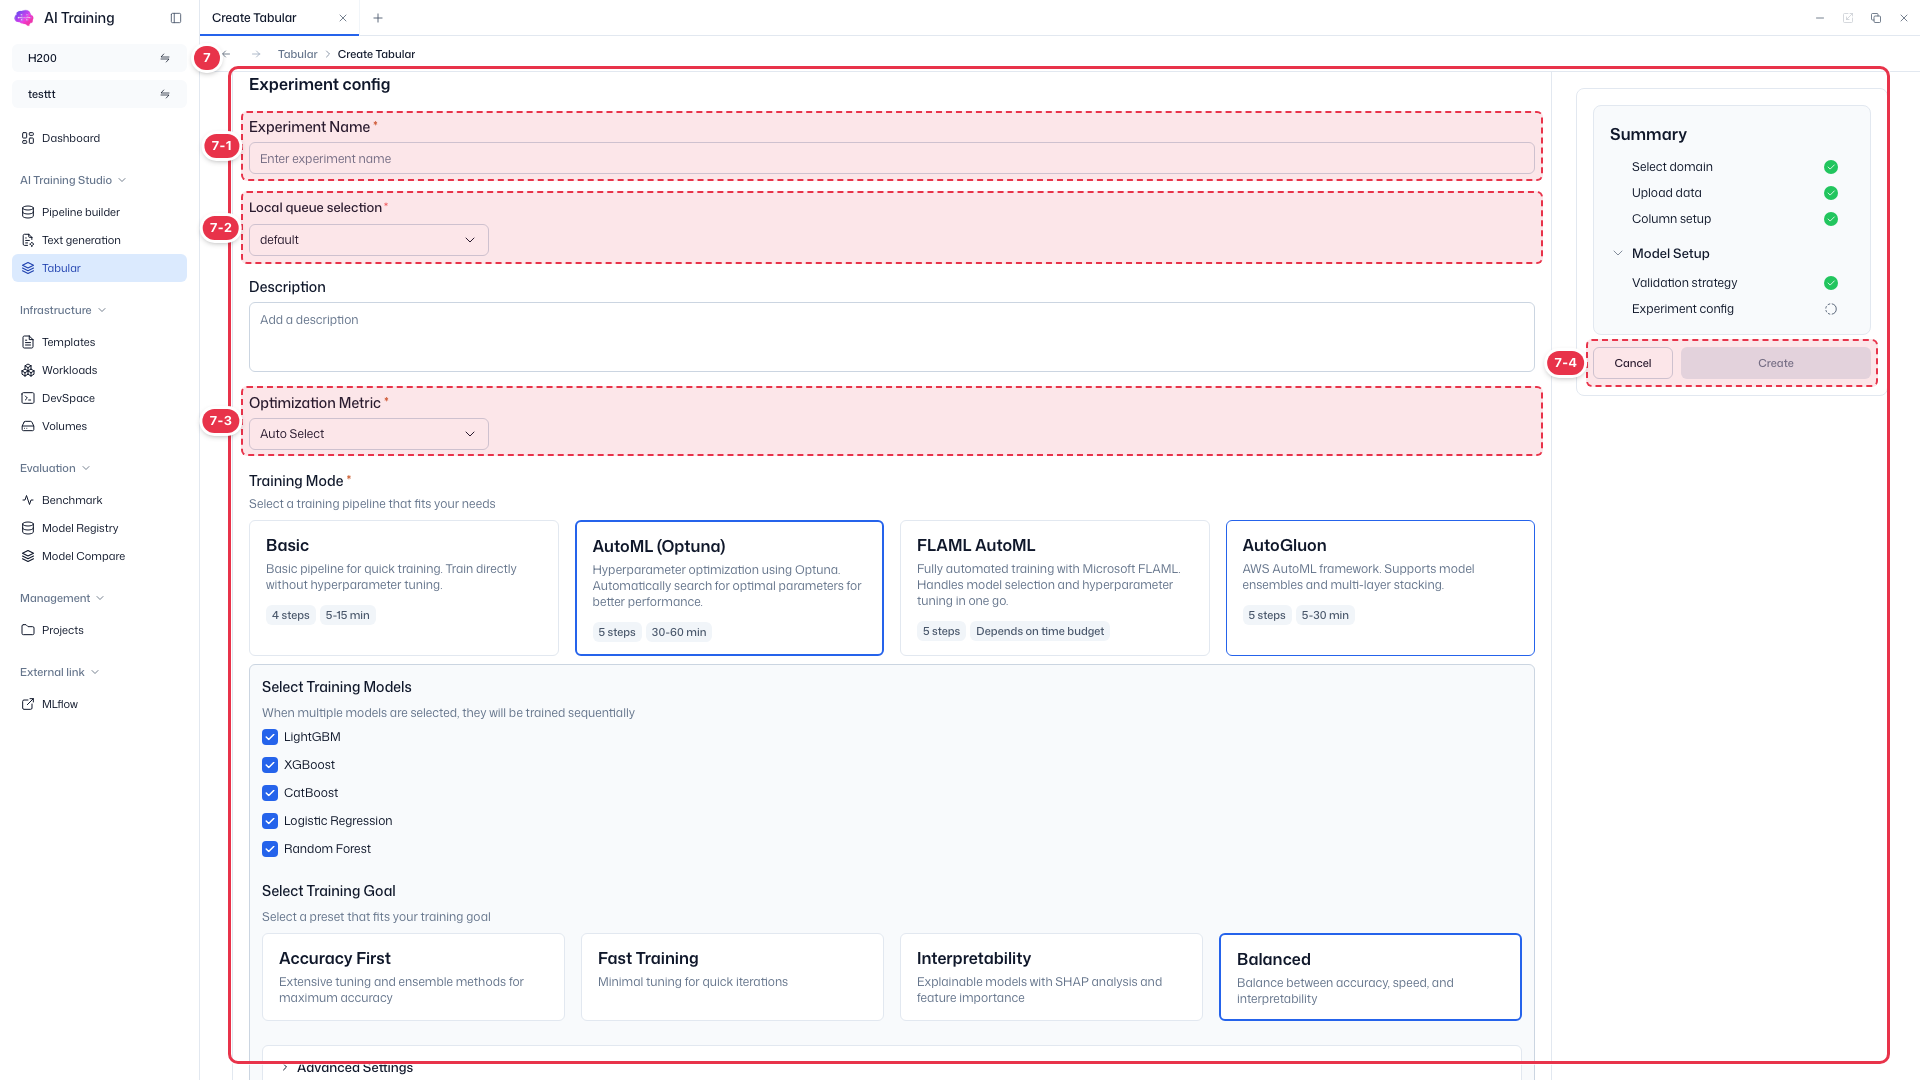
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 7-1 | 실험 이름 | Experiment Name * (필수) | · 실험 식별 이름. |
| 7-2 | 로컬 큐 | Local queue selection * (필수) | · 학습을 실행할 로컬 큐. |
| 7-3 | 최적화 지표 | Optimization Metric * | · 모델 탐색 시 최적화할 지표. |
| 7-4 | 실험 생성 | Create / Cancel 버튼 | · Create: 실험을 생성·시작한다(모델 알고리즘: LightGBM·XGBoost·CatBoost·Logistic Regression·Random Forest 중 Auto Select 가능). · Cancel: 생성을 취소한다. |
1단계. Select domain (도메인·유즈케이스)
Create experiment(번호 1) 클릭 후, 마법사 상단 단계 탭(번호 2-1)을 따라 진행합니다.
- 업종 도메인 카드(번호 2-2)를 선택합니다(Finance, Marketing, E-commerce, Insurance, Telecom, Manufacturing, Security, Healthcare, Real Estate, General).
- 아래에 나타나는 Select a use case(번호 3-1)에서 use case 카드(번호 3-2)를 선택하면 Next가 활성화됩니다.
2단계. Upload data (데이터셋 선택)
학습에 사용할 데이터셋을 선택하거나 업로드합니다.
| 항목 | 번호 | 설명 |
|---|---|---|
| Recommended datasets | 4-1 | 도메인/유즈케이스에 맞는 추천 데이터셋 |
| My datasets | 4-2 | 프로젝트에 업로드된 사용자 데이터셋 |
| 검색 | 4-3 | 이름 등으로 데이터셋 검색 |
3단계. Column setup (컬럼 설정)
| 항목 | 번호 | 설명 |
|---|---|---|
| Target variable | 5-1 | 모델이 예측할 대상 컬럼(필수) |
| Exclude Columns | 5-2 | 학습에서 제외할 컬럼(선택) |
Target variable을 선택해야 Next가 활성화됩니다.
4단계. Model Setup (검증 전략·실험 구성)
Validation strategy
| 항목 | 번호 | 설명 |
|---|---|---|
| Split Method | 6-1 | Holdout · Cross Validation · Stratified K-Fold · Time Series |
| Train Data Ratio | 6-2 | Train / Validation / Test 비율(슬라이더) |
| Evaluation Metric | 6-3 | AUC · F1 · ACCURACY · LOGLOSS · MCC |
Experiment config
| 항목 | 번호 | 설명 |
|---|---|---|
| Experiment Name | 7-1 | 실험 식별 이름(필수) |
| Local queue selection | 7-2 | 학습 실행 로컬 큐(필수) |
| Optimization Metric | 7-3 | 모델 탐색 시 최적화할 지표 |
| Create / Cancel | 7-4 | 실험 생성·시작 / 취소 |
학습 모델은 Auto Select 또는 LightGBM · XGBoost · CatBoost · Logistic Regression · Random Forest 중에서 선택합니다. 설정을 확인한 뒤 Create(번호 7-4)를 클릭하면 실험이 생성·시작됩니다.