

파이프라인 구성
블록을 캔버스에 놓고 연결해 학습 파이프라인을 만들고 저장합니다. 저장한 파이프라인은 다시 불러와 이어서 편집할 수 있습니다.
아래 화면의 번호를 따라 주요 기능의 위치와 역할을 확인하세요.
Block library
파이프라인에 끌어다 놓을 수 있는 블록 목록. 클릭하거나 드래그해 캔버스에 추가한다.
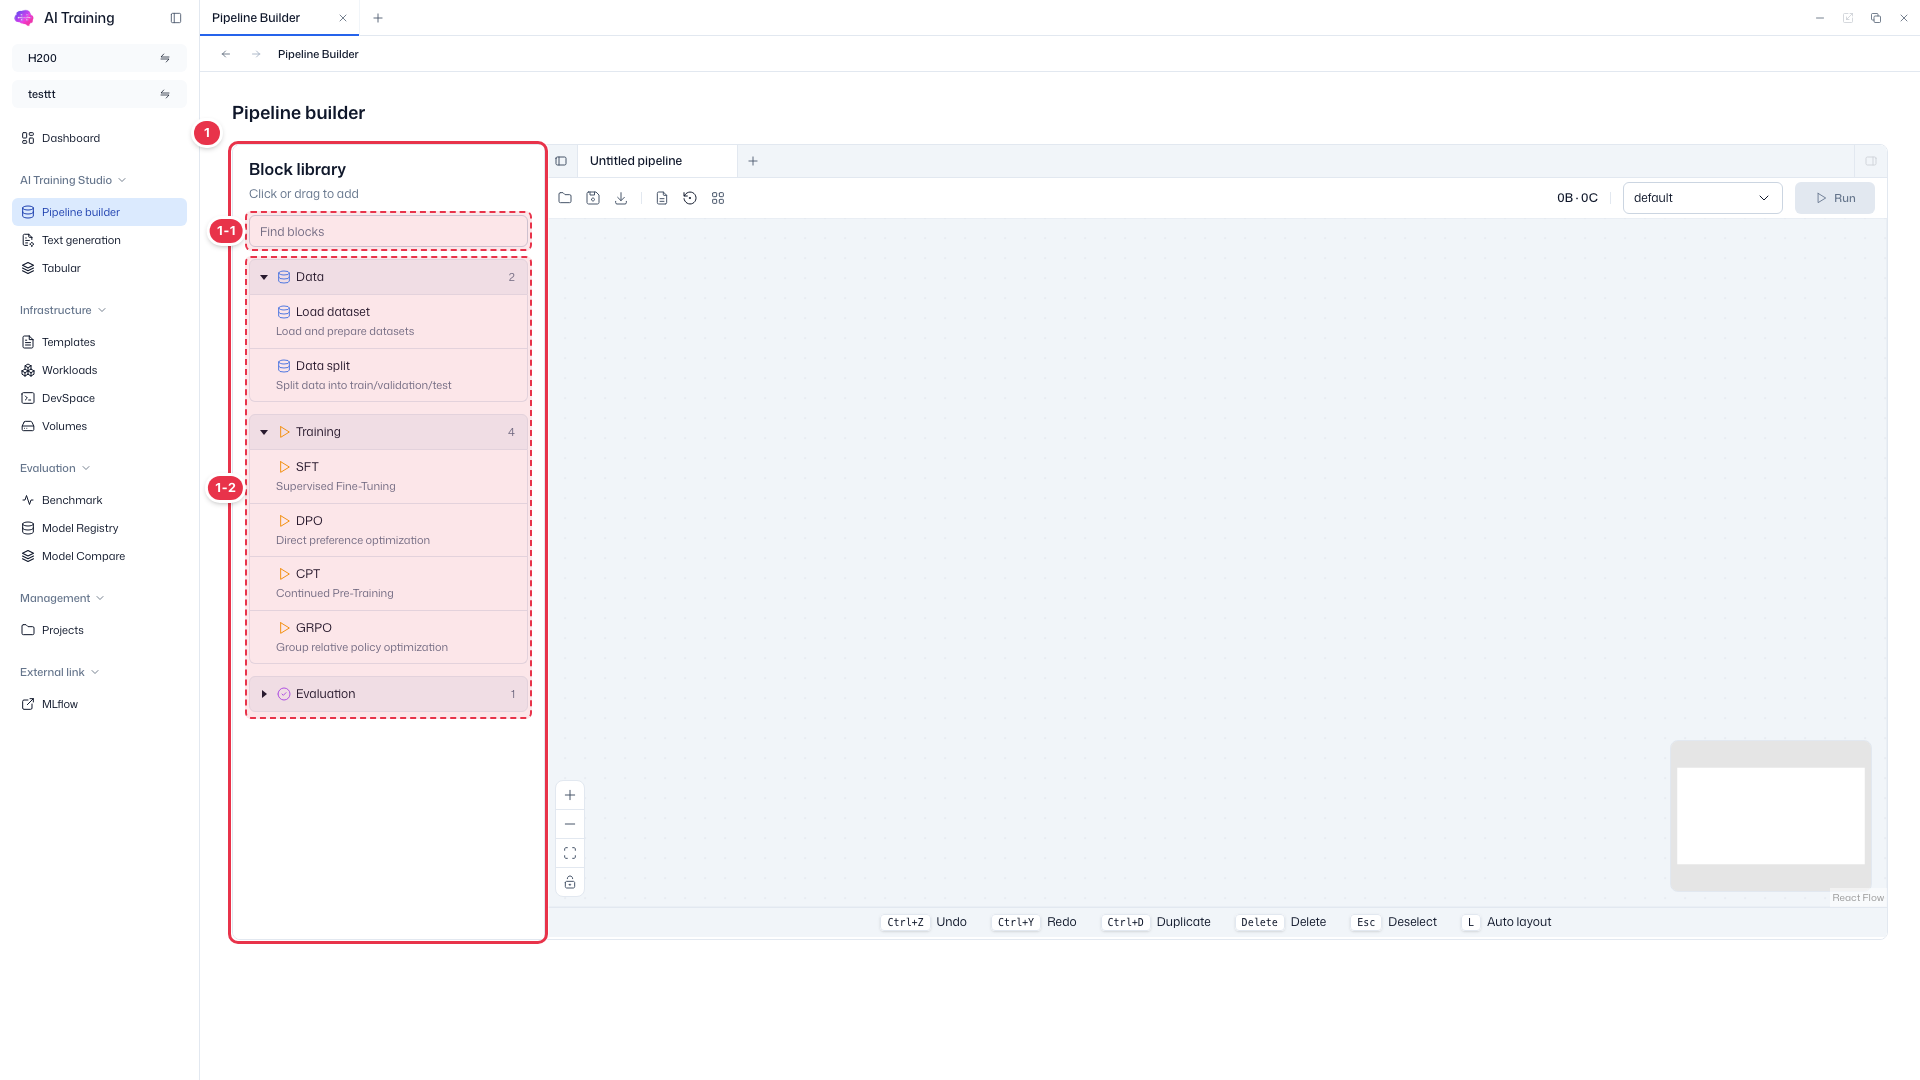
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 1-1 | 블록 검색 | Find blocks 입력창 | · 블록 이름으로 검색. |
| 1-2 | 블록 카테고리 | Data | Load dataset(데이터 로드) / Data split(train·val·test 분할). |
| Training | SFT / DPO / CPT / GRPO / GKD 등 학습 방법 블록. | ||
| Evaluation | 평가 블록. | ||
| MLflow | MLflow 연동 블록. |
캔버스 · 실행
블록을 연결해 파이프라인을 구성하고 실행하는 캔버스 영역.
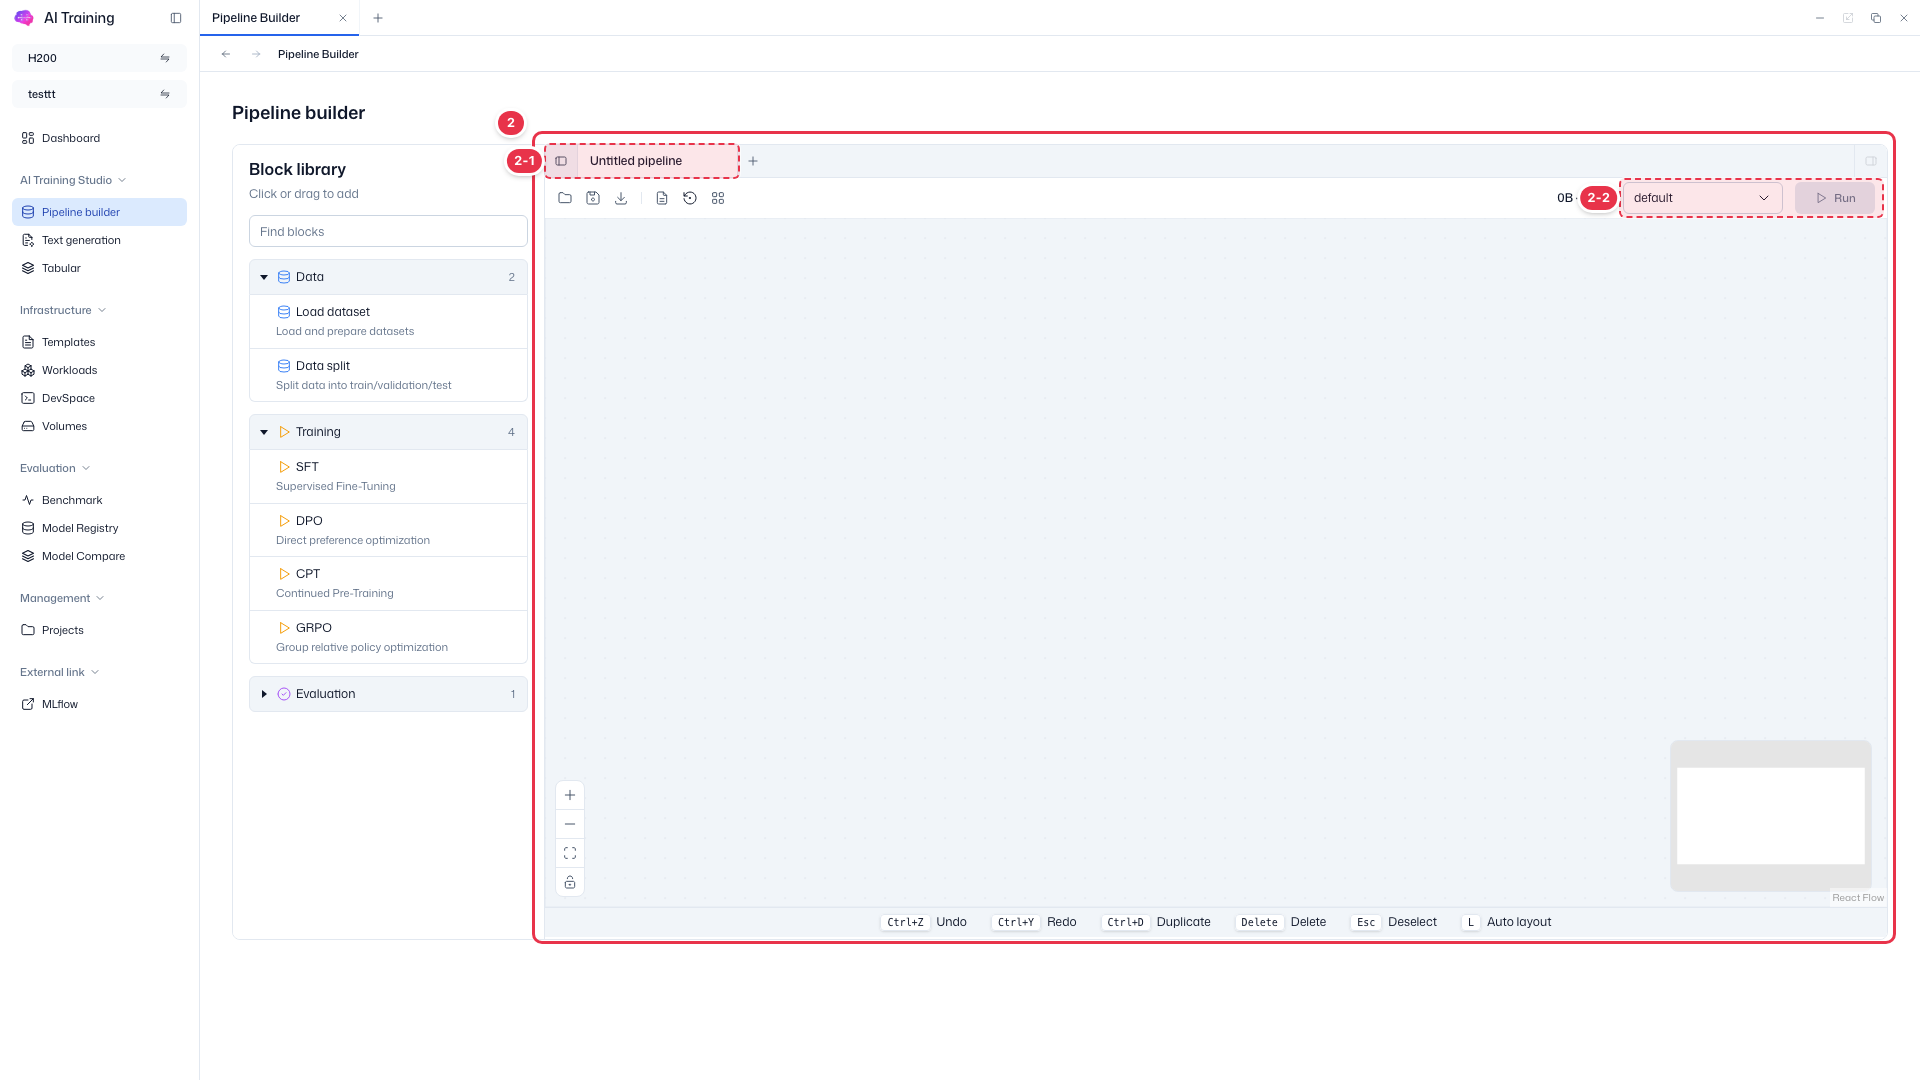
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 2-1 | 파이프라인 탭 | Untitled pipeline (+ 새 탭) | · 파이프라인을 탭 단위로 관리. + 로 새 파이프라인 추가. |
| 2-2 | 큐 · 실행 | 큐 선택(default) / Run | · 실행할 큐를 선택하고 Run으로 파이프라인을 실행한다. · 상단 툴바에서 열기·저장·다운로드 등을 수행. |
저장된 파이프라인 열기
캔버스 툴바 맨 왼쪽 폴더 아이콘을 누르면 저장해 둔 파이프라인 목록이 오른쪽에 열립니다.
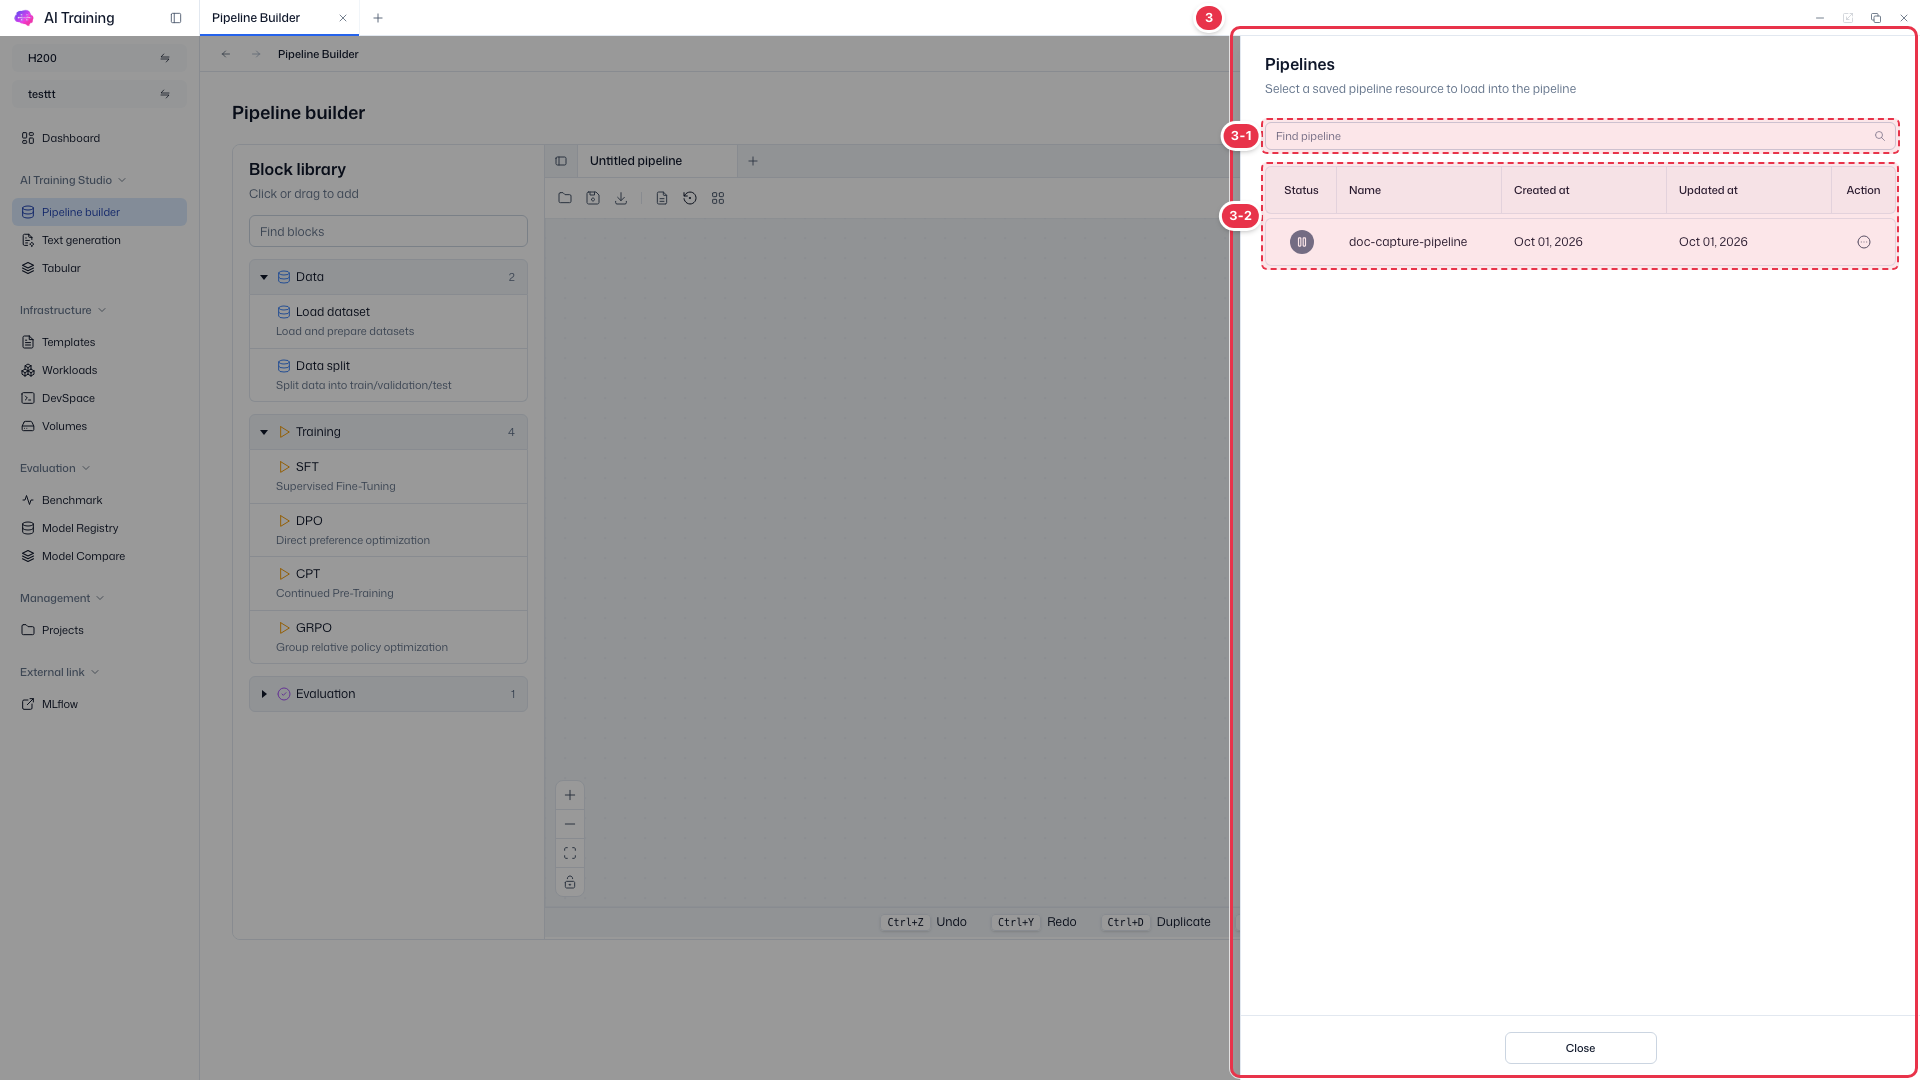
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 3-1 | 검색 | Find pipeline | · 파이프라인 이름으로 찾습니다. |
| 3-2 | 저장된 파이프라인 | Status · Name · Created at · Updated at | · 진행하던 파이프라인이 표시됩니다. 행 Action(⋯)에서 View Pipeline을 고르면 캔버스로 불러오고, Delete로 지울 수 있습니다. |
불러온 파이프라인
불러온 파이프라인이 새 탭으로 열립니다. 블록을 더 추가하거나 연결을 고친 뒤 저장하고 실행합니다.
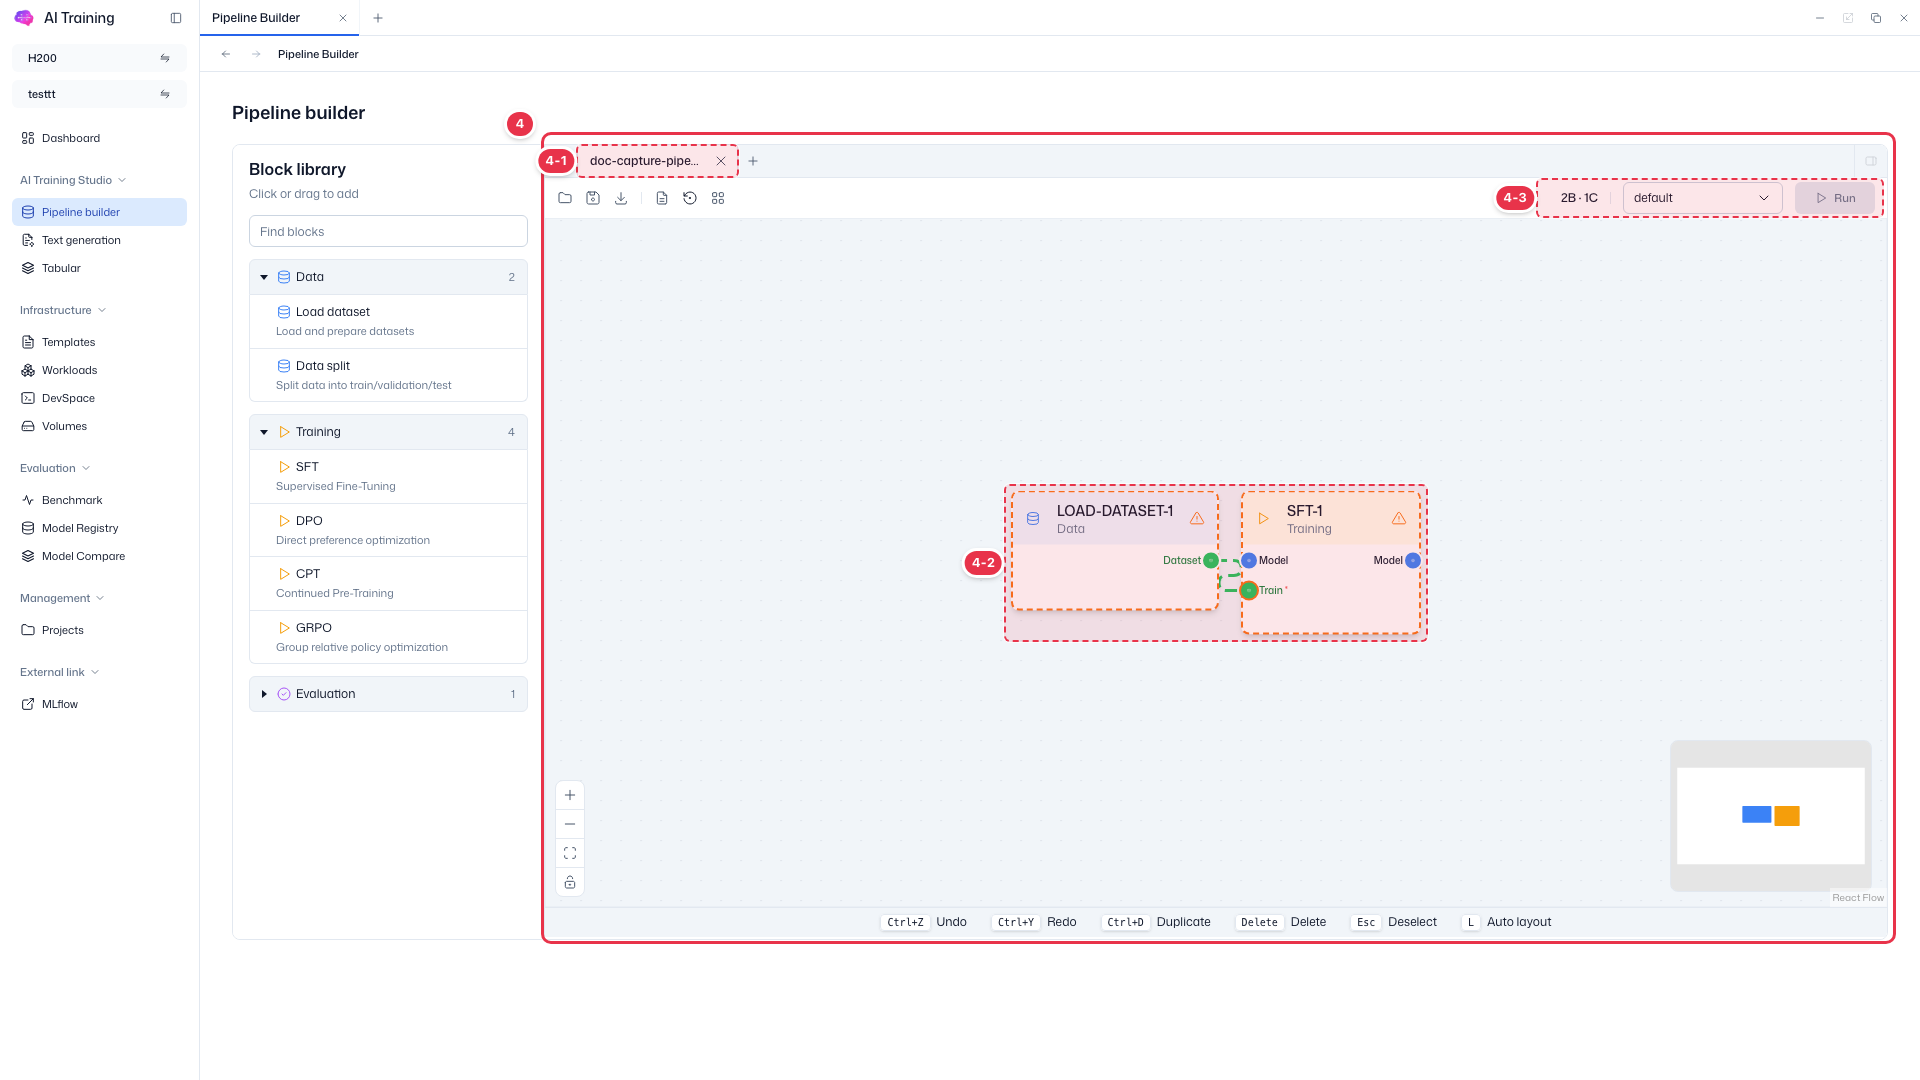
| 번호 | 기능 | 항목 | 설명 |
|---|---|---|---|
| 4-1 | 파이프라인 탭 | 파이프라인 이름 | · 불러온 파이프라인 이름으로 탭이 열립니다. |
| 4-2 | 블록 · 연결 | 예: LOAD-DATASET → SFT | · 블록의 출력 포트(예: Dataset)를 다음 블록의 입력 포트(예: Train)로 끌어 연결합니다. 경고 아이콘은 아직 채우지 않은 필수 설정이 있다는 뜻입니다. |
| 4-3 | 블록·연결 수 · 큐 · 실행 | 2B · 1C / default / Run | · 블록(B)과 연결(C) 수, 실행할 로컬 큐, Run 버튼입니다. 필수 설정을 모두 채우면 Run이 활성화됩니다. |
1단계. 블록 추가·연결
왼쪽 사이드바에서 AI Training Studio → Pipeline builder를 클릭합니다.
왼쪽 Block library(번호 1)에서 블록을 클릭하거나 캔버스로 끌어 놓습니다.
그룹 블록 Data Load dataset, Data split Training SFT, DPO, CPT, GRPO Evaluation 평가 블록 블록의 출력 포트(예: Load dataset의 Dataset)를 다음 블록의 입력 포트(예: SFT의 Train)로 끌어 연결합니다(번호 4-2 화면 참고).
블록을 클릭하면 오른쪽에 설정 패널이 열립니다. 경고 아이콘이 있는 블록은 필수 설정이 남아 있다는 뜻입니다.
2단계. 저장
캔버스 툴바의 저장 아이콘을 누르고 Pipeline name(필수)과 Description을 입력한 뒤 Save를 클릭합니다. 저장하면 캔버스 탭 이름이 파이프라인 이름으로 바뀝니다.
3단계. 저장한 파이프라인 불러오기
- 툴바 맨 왼쪽 폴더 아이콘을 누르면 Pipelines 목록(번호 3)이 열립니다.
- 불러올 파이프라인 행의 Action(⋯)에서 View Pipeline을 고릅니다. 필요 없는 파이프라인은 Delete로 지웁니다.
- 파이프라인이 새 탭으로 캔버스에 열립니다(번호 4).